Daniel Sossa, Data Scientist Junior et Full-Stack Developer

Daniel Sossa, debout, en gilet de costume

fig. a

Data Scientist Junior

fig. b

Full-Stack Developer

01

0

ans à écrire du code

02

0

stages en entreprise

03

0

projets freelance livrés

04

0

projets data

05

0 M

lignes analysées

§ 01 — Manifeste

Je construis des applications du premier appel à la mise en ligne. Puis j’ai ouvert une deuxième branche : les données. Aujourd’hui je fais les deux, et je pose toujours la même question : est-ce que ça tient face au réel ? 

§ 02 — Parcours

Deux branches,
un seul historique.

$ git log --graph --oneline --all

dev — depuis 2023

data — depuis 2026

  1. 2023

    Entrée en BTS Informatique

    5fd7ac9 git init

  2. Août 2024

    Premier stage · Palmafrique

    0bd1300 feat: premier stage

  3. 2024

    Premiers clients en freelance

    94a0665 feat: premiers clients

  4. 2025

    BTS obtenu

    1fe3004 git tag v1.0

  5. Sept. 2025

    Stage · Ebenyx Technologies

    b88a30d test: ne plus casser la prod

  6. Janv. 2026

    Bootcamp Data & IA · Epitech

    778f72d git checkout -b data

  7. Mai 2026

    Bourse ML Engineer · DataCamp

    0d787f3 chore: roadmap ML engineer

  8. Aujourd'hui

    Data Scientist × Full-Stack Developer

    420372b git merge data

    HEAD → main

Planche
02 · Parcours
Dessiné par
D. Sossa
Lieu
Abidjan, CI
Branches
dev 2023 · data 2026
Historique
8 commits · 1 merge
Échelle
1 commit = 1 étape

§ 03 — Travaux

Ce que j’ai
analysé.

Out[ ]: Model/Model.ipynb● Python 3
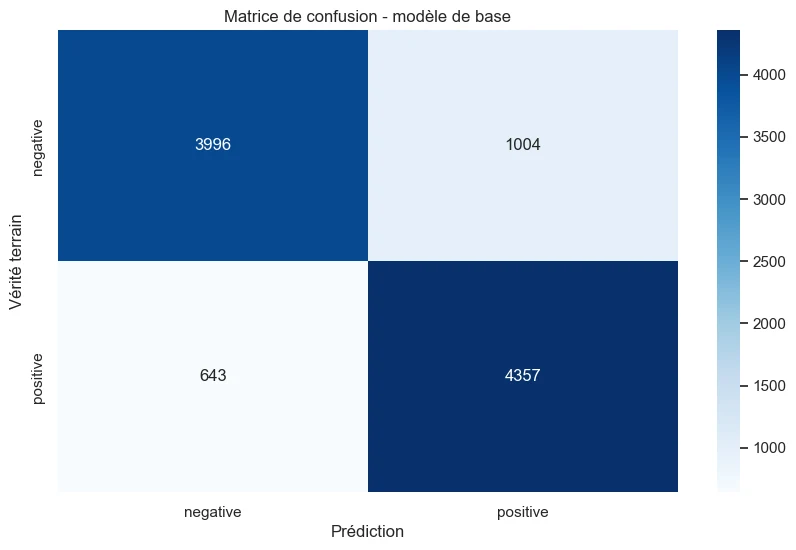
Graphique issu du notebook Pipeline de sentiment en temps réel

01Juin 2026

Pipeline de sentiment en temps réel

Des critiques de films classées positives ou négatives à la volée, de l’API jusqu’à PostgreSQL, orchestré par Kafka.

Accuracy finale
86,5 %
F1 (macro)
0,86
Critiques d’entraînement
50 000
PythonApache KafkaXGBoostTF-IDFPostgreSQLDocker ComposeKafka UI
Out[ ]: index.ipynb● Python 3
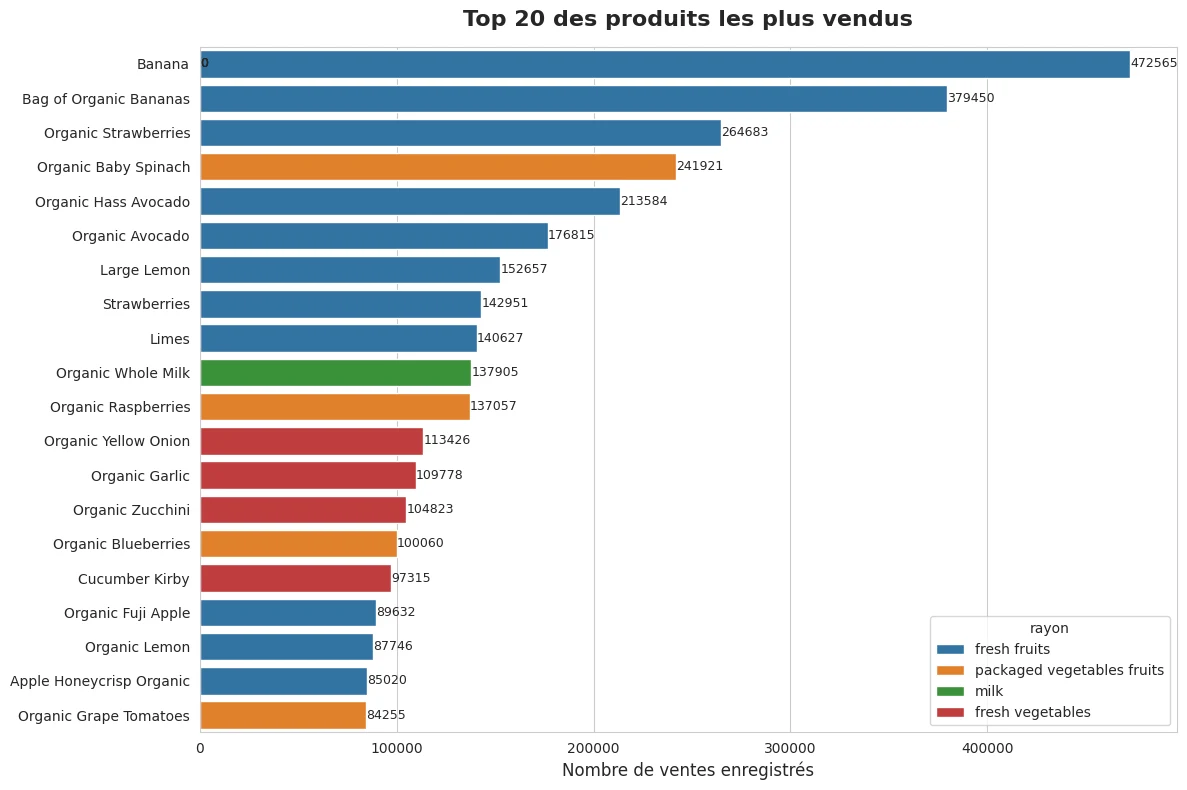
Graphique issu du notebook Comportements d’achat en e-commerce

02Mai 2026

Comportements d’achat en e-commerce

Qui achète quoi, quand, et qu’est-ce qui fait revenir : huit questions posées à des millions de commandes.

Lignes traitées
35 M+
Commandes
3 M+
Panier moyen
10 articles
PythonPandasSeabornMatplotlibPower BI

52

Livres

03Mai 2026

Un libraire qui aurait tout lu

52 livres du Project Gutenberg lus par un algorithme, regroupés par thèmes et recommandés par proximité de vocabulaire.

Livres
52
Tokens bruts
7,7 M
Bruit supprimé
60,4 %
PythonNLTKScikit-learnTF-IDFLSA

2

Modèles livrés

042026

JupyterHub sur Azure · prédiction médicale

Monter l’infrastructure collaborative sur le cloud, puis y entraîner deux modèles de prédiction médicale en équipe.

Modèles livrés
2
Rôle
Tech Lead
Infrastructure
Azure VM
PythonAzure VMJupyterHubScikit-learnPandas

4

Modules

052026

Piscine Python Data Science

Quatre modules enchaînés en une semaine : APIs, scraping, stockage, visualisation et serving.

Modules
4
Scraping
Prix PS5
Stockage
SQLite + Pickle
PythonFlaskSQLitePickleBeautifulSoup

§ 04 — Intersection

Là où les deux se rencontrent.

DataMachine LearningNLPPandasKafkaPower BIDevReactNext.jsTypeScriptLaravelExpressSQLFastAPIDockerDashboardsTests & CI

Data → Prod

Pipeline de sentiment temps réel

Un modèle XGBoost ne sert à rien seul : il a fallu Kafka, deux consumers, PostgreSQL et sept services Docker pour qu’il classe chaque commentaire dès son arrivée.

Dev → Data

SIGETI chez Ebenyx

Dans une application en production, concevoir les tableaux de bord et modules statistiques qui rendent les indicateurs métier lisibles.

Infra + ML

JupyterHub sur Azure

Monter l’environnement collaboratif avant d’entraîner les modèles. En tant que Tech Lead, l’infra était aussi mon problème.

§ 05 — Formation

Apprendre en continu.

Un BTS, un bootcamp, des certifications, et une bourse qui m’emmène jusqu’au MLOps : ce qui se passe après l’entraînement d’un modèle.

Bourse DataCamp × iSheero

ML Engineer Roadmap

Une bourse pour suivre le parcours complet d'un ingénieur machine learning : des bases du terminal jusqu'au monitoring d'un modèle en production.

28
ressources
7
étapes
  1. Fondations5 ressources

    Les outils du quotidien : la data science, Git, le terminal, le scripting et les bases NoSQL.

  2. Python & génie logiciel2 ressources

    Écrire du Python propre, testable et réutilisable, pas seulement des notebooks.

  3. Machine Learning4 ressources

    Supervisé, non supervisé, arbres de décision, et surtout : savoir valider un modèle.

  4. Deep Learning & NLP4 ressources

    Réseaux de neurones avec PyTorch, passage à l'échelle avec Lightning, et traitement du langage.

  5. Déploiement & serving6 ressources

    Suivre ses expériences, alléger un modèle et l'exposer derrière une API conteneurisée.

  6. Données à grande échelle2 ressources

    Comprendre les architectures de données modernes et traiter du volume avec Spark.

  7. Production & MLOps5 ressources

    Automatiser, orchestrer et surveiller : un modèle en production vit, dérive et doit être observé.

Diplômes & certifications

DiplômeN° 2023-01

BTS Informatique · Développeur d'Applications

GEIGE, Abidjan

Formation en développement logiciel, algorithmique et architecture applicative

Période2023 – 2025Diplôme obtenu
CertificationN° 2025-02

JavaScript Essentials 2

Cisco Networking Academy

Certification Cisco × OpenEDG JS Institute, orientée JavaScript avancé : programmation orientée objet, structures de données, code asynchrone

Array TechniquesComparison StrategiesDeep CloningEnumerating PropertiesGettersInheritance+8
PériodeSeptembre 2025 Vérifier
Formation intensiveN° 2026-03

Bootcamp Data Science & IA

Epitech Côte d'Ivoire

6 mois de formation intensive : Python, Machine Learning, Data Engineering, Azure

PériodeJanvier – Juillet 2026Programme terminé
CertificationN° 2026-04

Data Science Essentials with Python

Cisco Networking Academy

Certification Cisco validée par un examen : explorer, nettoyer, visualiser et modéliser des données avec Python et ses bibliothèques standard, puis communiquer les résultats.

Exploratory Data AnalysisData CleaningData VisualizationLinear RegressionPandas & MatplotlibJupyter Notebook+1
PériodeJuillet 2026 Vérifier