Pipeline de sentiment en temps réel
Des critiques de films classées positives ou négatives à la volée, de l’API jusqu’à PostgreSQL, orchestré par Kafka.
- Accuracy finale
- 86,5 %
- F1 (macro)
- 0,86
- Critiques d’entraînement
- 50 000
- Services Docker
- 7
La question
dataset · IMDB Dataset · 50 000 critiques équilibrées (50 / 50)
« Peut-on classer le sentiment d’un commentaire au moment où il arrive, et le stocker sans intervention humaine ? »
Architecture · docker compose
producer
récupère films et commentaires via l’API, publie sur movie-comments
kafka
topics movie-comments → movie-comments-classified
consumer_model
nettoie, vectorise (TF-IDF) et prédit avec XGBoost
consumer_postgres
enregistre chaque prédiction dans sentiment_db
postgres
stockage des commentaires classés
Le notebook
Les cellules s’exécutent en défilant. Chaque étape : l’explication, le résultat, et le code si vous voulez creuser. Le code et les sorties viennent directement du dépôt.
Analyse de sentiment IMDB · modèle XGBoost
Avant de brancher quoi que ce soit sur Kafka, il fallait un modèle fiable. Ce notebook couvre tout : nettoyage, vectorisation TF-IDF, modèle de base, recherche d’hyperparamètres et export des artefacts utilisés ensuite en production par le consumer.
1. Nettoyer le texte
Les critiques contiennent du HTML (<br />), des caractères d’échappement et beaucoup de mots vides. On les retire avant de vectoriser.
In [ ]:
1stop_words = set(stopwords.words('english'))2punct_marks = set(string.punctuation)3 4 5def clean_text(text: str) -> str:6 text = re.sub(r'<.*?>', '', text)7 text = text.replace('\\', ' ')8 text = text.replace('\n', ' ')9 return text.strip()10 11 12def tokenize_and_filter(text: str) -> str:13 sentences = sent_tokenize(text)14 tokens = []15 for sentence in sentences:16 for token in word_tokenize(sentence):17 token = token.lower()18 if token.isalpha() and token not in stop_words and token not in punct_marks:19 tokens.append(token)20 return ' '.join(tokens)21 22 23def preprocess_text(series: pd.Series) -> pd.Series:24 return series.map(clean_text).map(tokenize_and_filter)25 26print('Nettoyage en cours...')27df['review_clean'] = preprocess_text(df['review'])28 29df[['review', 'review_clean', 'sentiment']].head(5)2. Vectoriser avec TF-IDF
Unigrammes et bigrammes, plafonnés à 20 000 features : assez pour capter « not good » sans exploser la mémoire.
In [ ]:
1vectorizer = TfidfVectorizer(max_features=20000, ngram_range=(1, 2))2X = vectorizer.fit_transform(df['review_clean'])3y = df['sentiment'].map({'positive': 1, 'negative': 0}).astype(int)4 5print('Dimension du vocabulaire TF-IDF :', len(vectorizer.vocabulary_))6print('Matrice X shape :', X.shape)3. Un modèle de base pour se situer
Split 80 / 20 stratifié, XGBoost avec des paramètres raisonnables. C’est la référence à battre.
In [ ]:
1X_train, X_test, y_train, y_test = train_test_split(2 X, y, test_size=0.20, random_state=RANDOM_STATE, stratify=y3)4 5base_model = XGBClassifier(6 learning_rate=0.05,7 max_depth=7,8 n_estimators=200,9 # use_label_encoder=False,10 eval_metric='logloss',11 random_state=RANDOM_STATE,12 n_jobs=-113)14 15base_model.fit(X_train, y_train)16y_pred = base_model.predict(X_test)17base_accuracy = accuracy_score(y_test, y_pred)18 19print(f'Accuracy du modèle de base : {base_accuracy:.4f}')20print('\nRapport de classification :')21print(classification_report(y_test, y_pred, target_names=['negative', 'positive']))4. Chercher de meilleurs hyperparamètres
27 combinaisons de max_depth, learning_rate et n_estimators testées par validation croisée.
In [ ]:
1param_grid = {2 'max_depth': [3, 5, 7],3 'learning_rate': [0.01, 0.05, 0.1],4 'n_estimators': [100, 200, 300]5}6 7search_model = XGBClassifier(8 use_label_encoder=False,9 eval_metric='logloss',10 random_state=RANDOM_STATE,11 n_jobs=-112)13 14grid_search = GridSearchCV(15 estimator=search_model,16 param_grid=param_grid,17 scoring='accuracy',18 cv=2,19 verbose=1,20 n_jobs=-1,21 return_train_score=False22)In [ ]:
1grid_search.fit(X_train, y_train)2 3best_params = grid_search.best_params_4best_score = grid_search.best_score_5 6print('Meilleurs hyperparamètres :', best_params)7print(f'Accuracy CV moyenne du meilleur modèle : {best_score:.4f}')5. Évaluation finale
Le meilleur modèle gagne 3 points d’accuracy sur le jeu de test (0,835 → 0,865), avec un rappel équilibré entre les deux classes.
In [ ]:
1final_accuracy = accuracy_score(y_test, y_pred_best)2print(f'Accuracy finale sur le test : {final_accuracy:.4f}')3print('\nRapport de classification final :')4print(classification_report(y_test, y_pred_best, target_names=['negative', 'positive']))5 6cm_best = confusion_matrix(y_test, y_pred_best)7sns.heatmap(cm_best, annot=True, fmt='d', cmap='Greens', xticklabels=['negative', 'positive'], yticklabels=['negative', 'positive'])8plt.title('Matrice de confusion - meilleur modèle')9plt.xlabel('Prédiction')10plt.ylabel('Vérité terrain')11plt.show()6. Du notebook à la production
Le modèle et le vectoriseur sont exportés en .pkl, puis chargés par le service consumer_model, qui classe chaque message Kafka et le republie sur un topic dédié.
In [ ]:
consumer/consumer_classifier.py
1def classify(text, vectorizer, model):2 cleaned = preprocess_step(text)3 features = vectorizer.transform([cleaned])4 prediction = model.predict(features)[0]5 6 label = str(prediction).lower()7 if label == "1":8 return "positive"9 else:10 return "negative"Pipeline de sentiment en temps réel · cellules et sorties issues du dépôt GitHub
Analyse de sentiment IMDB · modèle XGBoost
Avant de brancher quoi que ce soit sur Kafka, il fallait un modèle fiable. Ce notebook couvre tout : nettoyage, vectorisation TF-IDF, modèle de base, recherche d’hyperparamètres et export des artefacts utilisés ensuite en production par le consumer.
Étape 011/6
Nettoyer le texte
Les critiques contiennent du HTML (
<br />), des caractères d’échappement et beaucoup de mots vides. On les retire avant de vectoriser.In [1]stop_words = set(stopwords.words('english'))29 l.
1stop_words = set(stopwords.words('english'))2punct_marks = set(string.punctuation)3 4 5def clean_text(text: str) -> str:6 text = re.sub(r'<.*?>', '', text)7 text = text.replace('\\', ' ')8 text = text.replace('\n', ' ')9 return text.strip()10 11 12def tokenize_and_filter(text: str) -> str:13 sentences = sent_tokenize(text)14 tokens = []15 for sentence in sentences:16 for token in word_tokenize(sentence):17 token = token.lower()18 if token.isalpha() and token not in stop_words and token not in punct_marks:19 tokens.append(token)20 return ' '.join(tokens)21 22 23def preprocess_text(series: pd.Series) -> pd.Series:24 return series.map(clean_text).map(tokenize_and_filter)25 26print('Nettoyage en cours...')27df['review_clean'] = preprocess_text(df['review'])28 29df[['review', 'review_clean', 'sentiment']].head(5)Out[1]
Nettoyage en cours...
Étape 022/6
Vectoriser avec TF-IDF
Unigrammes et bigrammes, plafonnés à 20 000 features : assez pour capter « not good » sans exploser la mémoire.
In [2]vectorizer = TfidfVectorizer(max_features=20000, ngram_range=(1, 2))6 l.
1vectorizer = TfidfVectorizer(max_features=20000, ngram_range=(1, 2))2X = vectorizer.fit_transform(df['review_clean'])3y = df['sentiment'].map({'positive': 1, 'negative': 0}).astype(int)4 5print('Dimension du vocabulaire TF-IDF :', len(vectorizer.vocabulary_))6print('Matrice X shape :', X.shape)Out[2]
Dimension du vocabulaire TF-IDF : 20000
Matrice X shape : (50000, 20000)
Étape 033/6
Un modèle de base pour se situer
Split 80 / 20 stratifié, XGBoost avec des paramètres raisonnables. C’est la référence à battre.
In [3]X_train, X_test, y_train, y_test = train_test_split(21 l.
1X_train, X_test, y_train, y_test = train_test_split(2 X, y, test_size=0.20, random_state=RANDOM_STATE, stratify=y3)4 5base_model = XGBClassifier(6 learning_rate=0.05,7 max_depth=7,8 n_estimators=200,9 # use_label_encoder=False,10 eval_metric='logloss',11 random_state=RANDOM_STATE,12 n_jobs=-113)14 15base_model.fit(X_train, y_train)16y_pred = base_model.predict(X_test)17base_accuracy = accuracy_score(y_test, y_pred)18 19print(f'Accuracy du modèle de base : {base_accuracy:.4f}')20print('\nRapport de classification :')21print(classification_report(y_test, y_pred, target_names=['negative', 'positive']))Out[3]
Accuracy du modèle de base : 0.8353

Rapport de classification :
              precision    recall  f1-score   support

    negative       0.86      0.80      0.83      5000
    positive       0.81      0.87      0.84      5000

    accuracy                           0.84     10000
   macro avg       0.84      0.84      0.84     10000
weighted avg       0.84      0.84      0.84     10000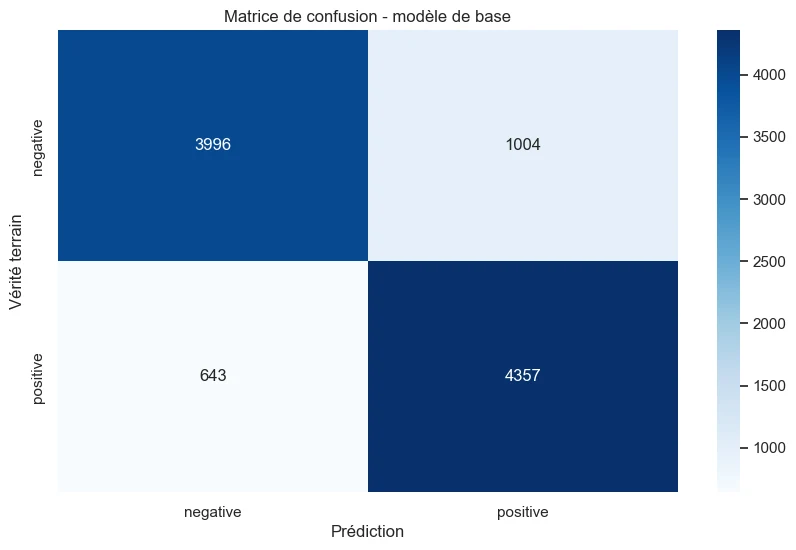
Étape 044/6
Chercher de meilleurs hyperparamètres
27 combinaisons de
max_depth,learning_rateetn_estimatorstestées par validation croisée.In [4]param_grid = {22 l.
1param_grid = {2 'max_depth': [3, 5, 7],3 'learning_rate': [0.01, 0.05, 0.1],4 'n_estimators': [100, 200, 300]5}6 7search_model = XGBClassifier(8 use_label_encoder=False,9 eval_metric='logloss',10 random_state=RANDOM_STATE,11 n_jobs=-112)13 14grid_search = GridSearchCV(15 estimator=search_model,16 param_grid=param_grid,17 scoring='accuracy',18 cv=2,19 verbose=1,20 n_jobs=-1,21 return_train_score=False22)In [5]grid_search.fit(X_train, y_train)7 l.
1grid_search.fit(X_train, y_train)2 3best_params = grid_search.best_params_4best_score = grid_search.best_score_5 6print('Meilleurs hyperparamètres :', best_params)7print(f'Accuracy CV moyenne du meilleur modèle : {best_score:.4f}')Out[5]
Fitting 2 folds for each of 27 candidates, totalling 54 fits
Meilleurs hyperparamètres : {'learning_rate': 0.1, 'max_depth': 7, 'n_estimators': 300}
Accuracy CV moyenne du meilleur modèle : 0.8561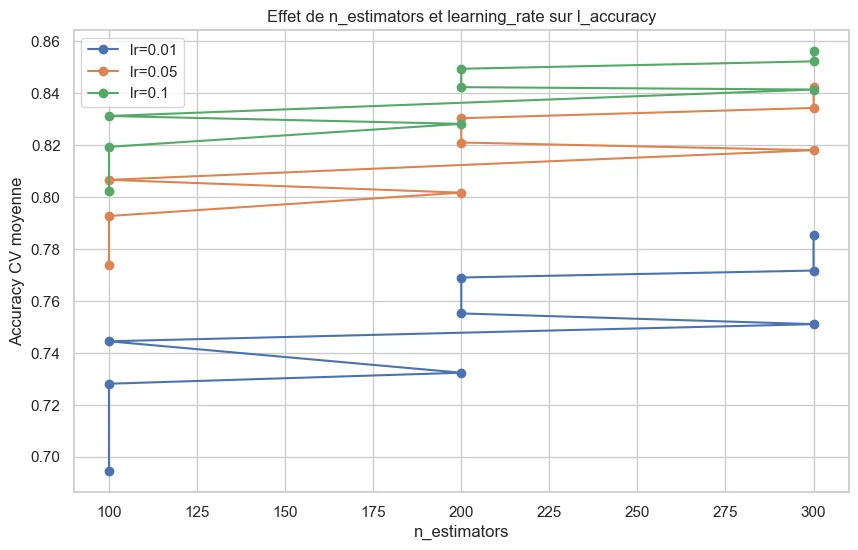
Étape 055/6
Évaluation finale
Le meilleur modèle gagne 3 points d’accuracy sur le jeu de test (0,835 → 0,865), avec un rappel équilibré entre les deux classes.
In [6]final_accuracy = accuracy_score(y_test, y_pred_best)11 l.
1final_accuracy = accuracy_score(y_test, y_pred_best)2print(f'Accuracy finale sur le test : {final_accuracy:.4f}')3print('\nRapport de classification final :')4print(classification_report(y_test, y_pred_best, target_names=['negative', 'positive']))5 6cm_best = confusion_matrix(y_test, y_pred_best)7sns.heatmap(cm_best, annot=True, fmt='d', cmap='Greens', xticklabels=['negative', 'positive'], yticklabels=['negative', 'positive'])8plt.title('Matrice de confusion - meilleur modèle')9plt.xlabel('Prédiction')10plt.ylabel('Vérité terrain')11plt.show()Out[6]
Accuracy finale sur le test : 0.8646

Rapport de classification final :
              precision    recall  f1-score   support

    negative       0.88      0.85      0.86      5000
    positive       0.85      0.88      0.87      5000

    accuracy                           0.86     10000
   macro avg       0.86      0.86      0.86     10000
weighted avg       0.86      0.86      0.86     10000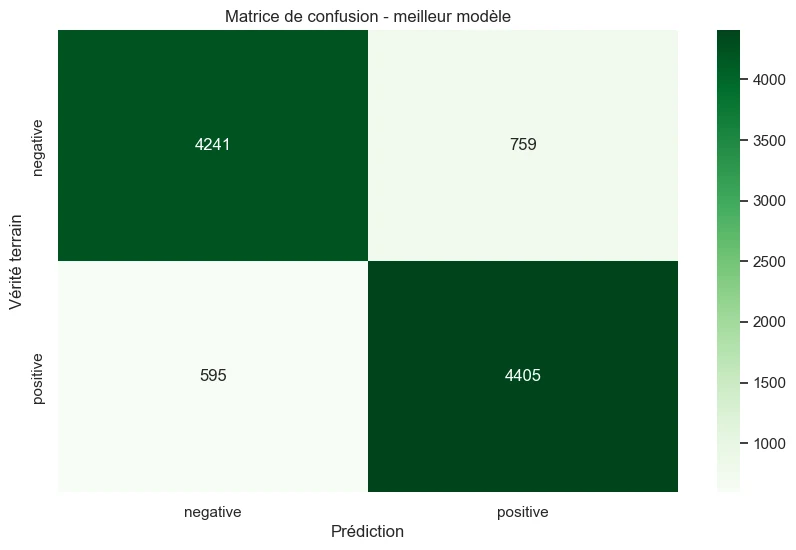
Étape 066/6
Du notebook à la production
Le modèle et le vectoriseur sont exportés en
.pkl, puis chargés par le serviceconsumer_model, qui classe chaque message Kafka et le republie sur un topic dédié.In [7]consumer/consumer_classifier.py10 l.
1def classify(text, vectorizer, model):2 cleaned = preprocess_step(text)3 features = vectorizer.transform([cleaned])4 prediction = model.predict(features)[0]5 6 label = str(prediction).lower()7 if label == "1":8 return "positive"9 else:10 return "negative"
Ce qu’il faut retenir
- 1La recherche d’hyperparamètres fait passer l’accuracy de 83,5 % à 86,5 % sur 10 000 critiques de test.
- 2Les erreurs restantes sont équilibrées : ni la classe positive ni la négative n’est sacrifiée.
- 3Tout le pipeline démarre avec une seule commande : docker compose up --build.
Et ensuite
- Mesurer la latence de bout en bout et le débit par consumer.
- Tester un modèle de type transformer pour capter l’ironie et les négations longues.