Comportements d’achat en e-commerce
Qui achète quoi, quand, et qu’est-ce qui fait revenir : huit questions posées à des millions de commandes.
- Lignes traitées
- 35 M+
- Commandes
- 3 M+
- Panier moyen
- 10 articles
- Pic d’activité
- 10h – 16h
La question
dataset · aisles · departments · products · orders · order_products
« Quels produits, quels moments et quels rayons font vraiment la performance du magasin ? »
Le notebook
Les cellules s’exécutent en défilant. Chaque étape : l’explication, le résultat, et le code si vous voulez creuser. Le code et les sorties viennent directement du dépôt.
Analyse comportementale des achats
Cinq fichiers CSV à croiser : produits, rayons, départements, commandes et lignes de commande. L’objectif est de transformer ces tables en décisions de merchandising et de gestion des stocks.
1. Les produits les plus vendus
On joint commandes, produits et rayons, puis on compte les ventes par produit.
In [ ]:
1import matplotlib.pyplot as plt2import seaborn as sb3 4PRODUCT_NAME_ID = product_dataframe[["product_id","product_name","aisle_id"]].drop_duplicates()5ORDER_PRODUCT = order_product_dataframe[["product_id","order_id","reordered"]].drop_duplicates()6PRODUCT_AND_AISLE = PRODUCT_NAME_ID.merge(aisles_dataFrame,on="aisle_id",how="inner").drop(columns="aisle_id")7 8# Jointure : commandes + produits pour obtenir un historique complet9ORDER_PRODUCT_DATA_FRAME = order_dataframe.merge(ORDER_PRODUCT,how='inner',on="order_id").merge(10 PRODUCT_AND_AISLE,on="product_id",how='inner'11 ).drop(columns=["days_since_prior_order", "eval_set"])12 13# Agrégation : comptage des ventes par produit14Result = ORDER_PRODUCT_DATA_FRAME.groupby("product_name",as_index=False).agg(15 Nombre_de_vente = pd.NamedAgg("order_id","count"),16 rayon = pd.NamedAgg("aisle","first")17).sort_values(by='Nombre_de_vente', ascending=False).reset_index()18 19# Sélection du Top 2020data = Result.drop_duplicates().head(20).reset_index()21data.to_csv('output/les_produit_les_plus_vendus.csv',index=False)Observation : les fruits frais et légumes emballés dominent. La banane arrive en tête, loin devant les autres.
2. Quand les clients commandent-ils ?
In [ ]:
1# Déterminer le nombre de commandes par jour 2order_dataframe.dropna(subset=["order_dow"],inplace=True)3ORDER_DATA_PER_DAYS = order_dataframe.groupby("order_dow",as_index=False).agg(4 Orders = pd.NamedAgg("order_id","count")5)6# changer les chiffres de order_dow par les nom exactes des jours7DAYS = pd.DataFrame({ "number": [0,1,2,3,4,5,6], "day":["Monday","Tuesday","Wednesday","Thursday","Friday","Saturday","Sunday"]8})9ORDER_DATA_PER_DAYS['day'] = DAYS.loc[ORDER_DATA_PER_DAYS["order_dow"],"day"]10 11# Déterminer les commandes par heure12ORDER_DATA_PER_HOUR = order_dataframe.groupby("order_hour_of_day",as_index=False).agg(13 Orders = pd.NamedAgg("order_id","count")14)15ORDER_DATA_PER_HOUR.to_csv('output/Nombres_de vente_par_heure.csv')16ORDER_DATA_PER_DAYS.to_csv('output/Nombres_de_ventes_par_jour.csv')Observation : pic en début de semaine et entre 10h et 16h, chute nette après 18h. Utile pour caler les promotions et les livraisons.
3. Quels rayons rapportent le plus ?
In [ ]:
1# jointure produits × rayons × lignes de commande, puis agrégation par rayon et par département4. La taille du panier
In [ ]:
1#Agrégation: Comptage d'article par commandes 2ITEMS_BUY_PEOPLE = ORDER_PRODUCT_DATA_FRAME.groupby("order_id").agg(3 NUMBER_OF_ITEMS = pd.NamedAgg("product_id","count")4).sort_values(by='NUMBER_OF_ITEMS', ascending=False)5# Calcul des indicateurs statistiques clés6Moy = int(ITEMS_BUY_PEOPLE["NUMBER_OF_ITEMS"].mean())7Max = int(ITEMS_BUY_PEOPLE["NUMBER_OF_ITEMS"].max())8Min = int(ITEMS_BUY_PEOPLE["NUMBER_OF_ITEMS"].min())9# Mise en forme pour visualisation10Result = pd.DataFrame({"colonne" : ["Maximum","Moyenne","Minimum"], "valeur" :[Max,Moy,Min]})11Result.to_csv("output/taille_du_panier_moyen.csv")Observation : 10 articles en moyenne, jusqu’à 145 pour certaines commandes groupées. Distribution asymétrique à droite.
5. Le délai entre deux commandes influence-t-il le rachat ?
In [ ]:
1ORDER_DATA_PRODUCT = order_product_dataframe.merge(order_dataframe,on="order_id")2REODERED_AND_DAY_AFTER = ORDER_DATA_PRODUCT[["order_id","product_id","reordered","days_since_prior_order"]].dropna()3 4Result2 = REODERED_AND_DAY_AFTER.groupby("reordered").agg(5 moyenne_jours = pd.NamedAgg("days_since_prior_order", "mean"),6 median_jours = pd.NamedAgg("days_since_prior_order", "median"),7).astype(int)8Result2.index = ["Non racheté", "Racheté"]9 10Result211 12REODERED_AND_DAY_AFTER.to_csv("le_delai_depuis_la_commande_influence_le_reachat.csv")Observation : ceux qui rachètent reviennent après 10 jours en moyenne, contre 12 pour les autres. Plus le délai s’allonge, moins on rachète le même produit.
Comportements d’achat en e-commerce · cellules et sorties issues du dépôt GitHub
Analyse comportementale des achats
Cinq fichiers CSV à croiser : produits, rayons, départements, commandes et lignes de commande. L’objectif est de transformer ces tables en décisions de merchandising et de gestion des stocks.
Étape 011/5
Les produits les plus vendus
On joint commandes, produits et rayons, puis on compte les ventes par produit.
In [1]import matplotlib.pyplot as plt21 l.
1import matplotlib.pyplot as plt2import seaborn as sb3 4PRODUCT_NAME_ID = product_dataframe[["product_id","product_name","aisle_id"]].drop_duplicates()5ORDER_PRODUCT = order_product_dataframe[["product_id","order_id","reordered"]].drop_duplicates()6PRODUCT_AND_AISLE = PRODUCT_NAME_ID.merge(aisles_dataFrame,on="aisle_id",how="inner").drop(columns="aisle_id")7 8# Jointure : commandes + produits pour obtenir un historique complet9ORDER_PRODUCT_DATA_FRAME = order_dataframe.merge(ORDER_PRODUCT,how='inner',on="order_id").merge(10 PRODUCT_AND_AISLE,on="product_id",how='inner'11 ).drop(columns=["days_since_prior_order", "eval_set"])12 13# Agrégation : comptage des ventes par produit14Result = ORDER_PRODUCT_DATA_FRAME.groupby("product_name",as_index=False).agg(15 Nombre_de_vente = pd.NamedAgg("order_id","count"),16 rayon = pd.NamedAgg("aisle","first")17).sort_values(by='Nombre_de_vente', ascending=False).reset_index()18 19# Sélection du Top 2020data = Result.drop_duplicates().head(20).reset_index()21data.to_csv('output/les_produit_les_plus_vendus.csv',index=False)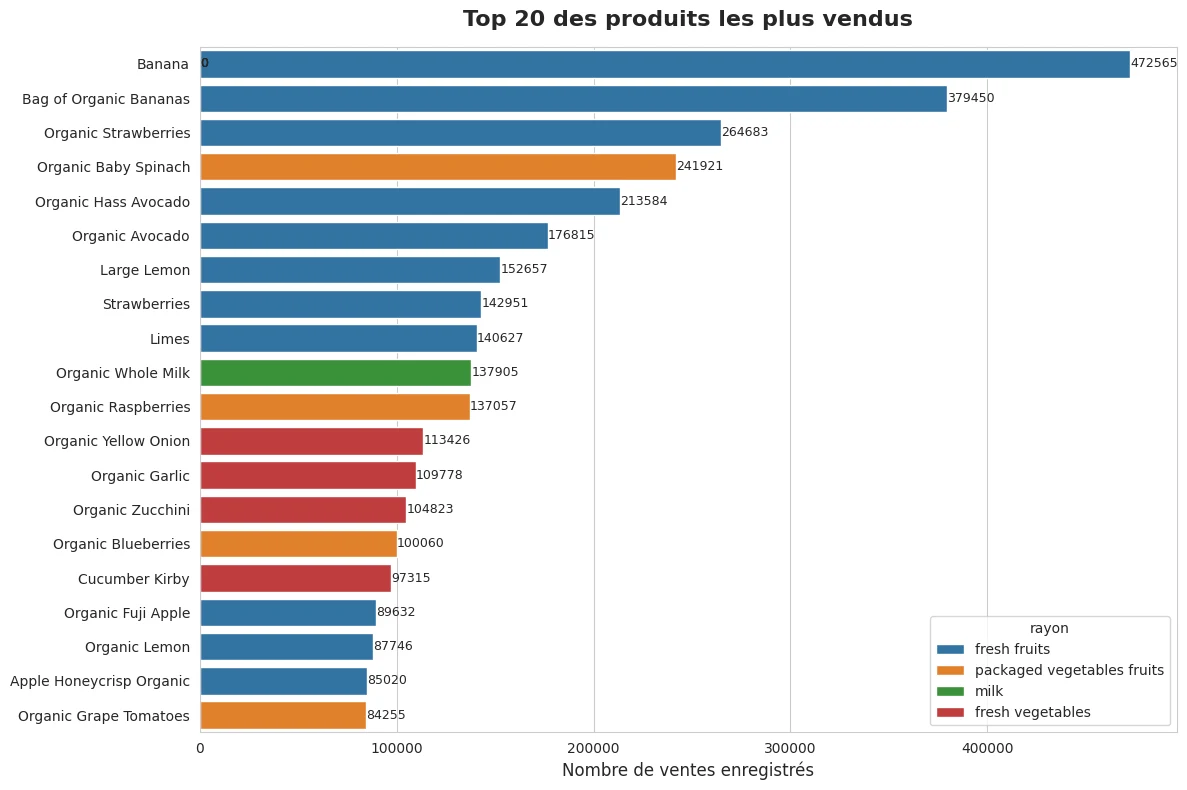
Observation : les fruits frais et légumes emballés dominent. La banane arrive en tête, loin devant les autres.
Étape 022/5
Quand les clients commandent-ils ?
In [2]Déterminer le nombre de commandes par jour16 l.
1# Déterminer le nombre de commandes par jour 2order_dataframe.dropna(subset=["order_dow"],inplace=True)3ORDER_DATA_PER_DAYS = order_dataframe.groupby("order_dow",as_index=False).agg(4 Orders = pd.NamedAgg("order_id","count")5)6# changer les chiffres de order_dow par les nom exactes des jours7DAYS = pd.DataFrame({ "number": [0,1,2,3,4,5,6], "day":["Monday","Tuesday","Wednesday","Thursday","Friday","Saturday","Sunday"]8})9ORDER_DATA_PER_DAYS['day'] = DAYS.loc[ORDER_DATA_PER_DAYS["order_dow"],"day"]10 11# Déterminer les commandes par heure12ORDER_DATA_PER_HOUR = order_dataframe.groupby("order_hour_of_day",as_index=False).agg(13 Orders = pd.NamedAgg("order_id","count")14)15ORDER_DATA_PER_HOUR.to_csv('output/Nombres_de vente_par_heure.csv')16ORDER_DATA_PER_DAYS.to_csv('output/Nombres_de_ventes_par_jour.csv')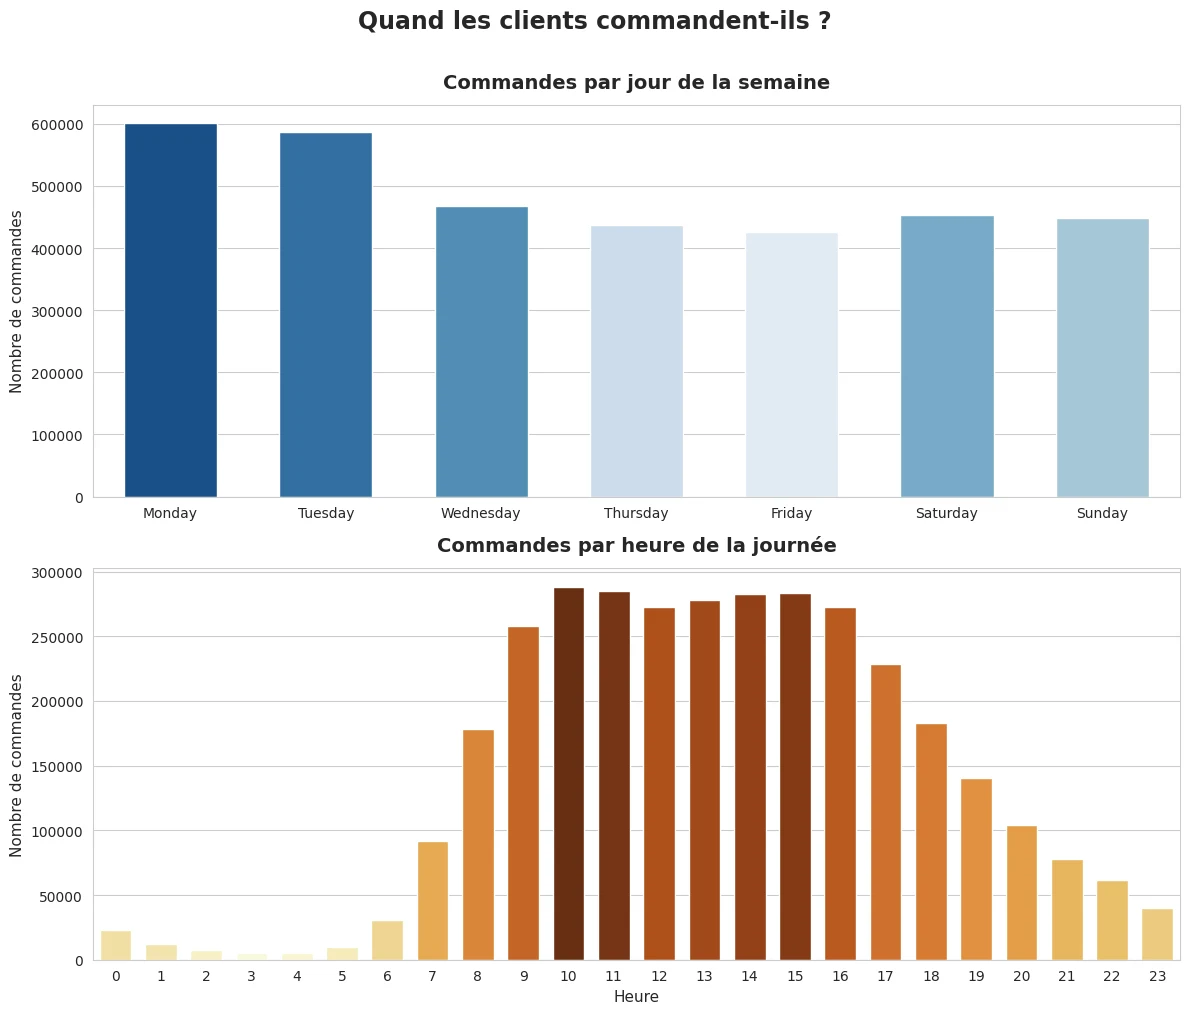
Observation : pic en début de semaine et entre 10h et 16h, chute nette après 18h. Utile pour caler les promotions et les livraisons.
Étape 033/5
Quels rayons rapportent le plus ?
In [3]jointure produits × rayons × lignes de commande, puis agrégation par rayon et par département1 l.
1# jointure produits × rayons × lignes de commande, puis agrégation par rayon et par département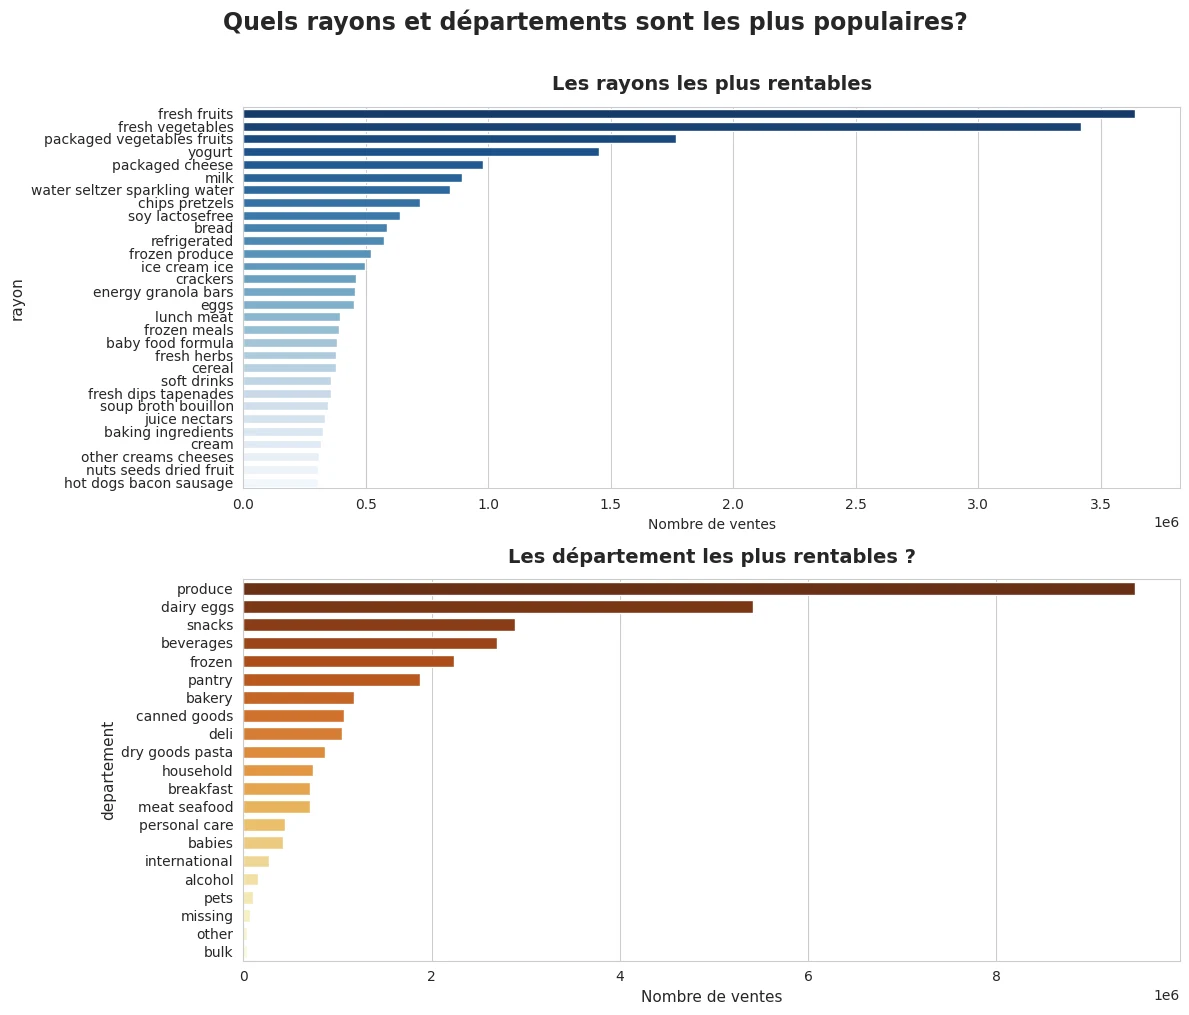
Étape 044/5
La taille du panier
In [4]Agrégation: Comptage d'article par commandes11 l.
1#Agrégation: Comptage d'article par commandes 2ITEMS_BUY_PEOPLE = ORDER_PRODUCT_DATA_FRAME.groupby("order_id").agg(3 NUMBER_OF_ITEMS = pd.NamedAgg("product_id","count")4).sort_values(by='NUMBER_OF_ITEMS', ascending=False)5# Calcul des indicateurs statistiques clés6Moy = int(ITEMS_BUY_PEOPLE["NUMBER_OF_ITEMS"].mean())7Max = int(ITEMS_BUY_PEOPLE["NUMBER_OF_ITEMS"].max())8Min = int(ITEMS_BUY_PEOPLE["NUMBER_OF_ITEMS"].min())9# Mise en forme pour visualisation10Result = pd.DataFrame({"colonne" : ["Maximum","Moyenne","Minimum"], "valeur" :[Max,Moy,Min]})11Result.to_csv("output/taille_du_panier_moyen.csv")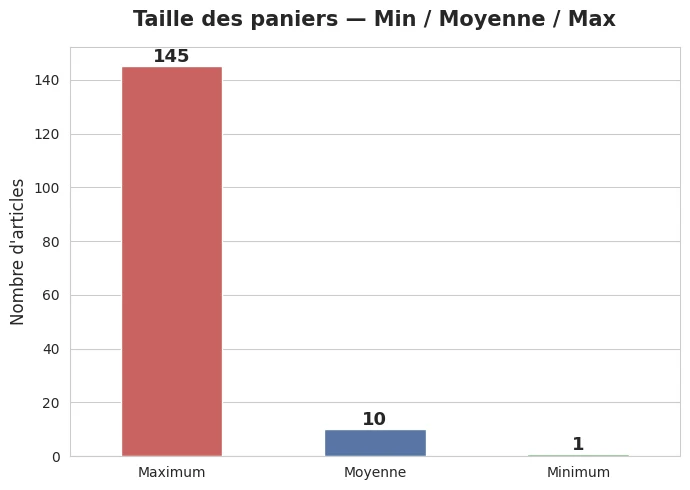
Observation : 10 articles en moyenne, jusqu’à 145 pour certaines commandes groupées. Distribution asymétrique à droite.
Étape 055/5
Le délai entre deux commandes influence-t-il le rachat ?
In [5]ORDER_DATA_PRODUCT = order_product_dataframe.merge(order_dataframe,on="order_id")12 l.
1ORDER_DATA_PRODUCT = order_product_dataframe.merge(order_dataframe,on="order_id")2REODERED_AND_DAY_AFTER = ORDER_DATA_PRODUCT[["order_id","product_id","reordered","days_since_prior_order"]].dropna()3 4Result2 = REODERED_AND_DAY_AFTER.groupby("reordered").agg(5 moyenne_jours = pd.NamedAgg("days_since_prior_order", "mean"),6 median_jours = pd.NamedAgg("days_since_prior_order", "median"),7).astype(int)8Result2.index = ["Non racheté", "Racheté"]9 10Result211 12REODERED_AND_DAY_AFTER.to_csv("le_delai_depuis_la_commande_influence_le_reachat.csv")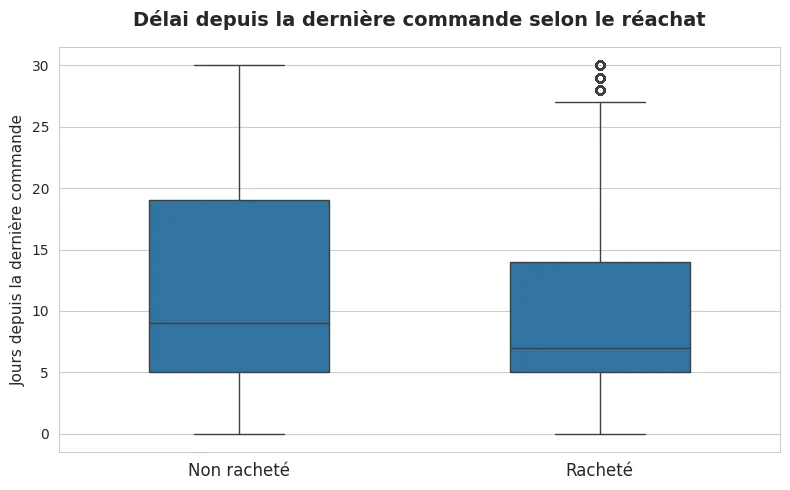
Observation : ceux qui rachètent reviennent après 10 jours en moyenne, contre 12 pour les autres. Plus le délai s’allonge, moins on rachète le même produit.
Ce qu’il faut retenir
- 1Les mêmes produits frais se retrouvent en tête des ventes, des premiers ajouts au panier et des rachats.
- 2L’activité se concentre en début de semaine et entre 10h et 16h.
- 3Un panier moyen d’environ 10 articles, avec des commandes groupées jusqu’à 145.
- 4Un client qui rachète revient plus vite (10 jours contre 12).
Et ensuite
- Segmenter les clients (RFM ou clustering) à partir de ces indicateurs.
- Publier le tableau de bord Power BI en ligne.